
白嫖 $300 算力!Vultr Serverless Inference 30天畅享 DeepSeek V4.1 Flash / GLM-5.3-Flash
2026 年 9 月,全球知名云基础设施服务商 Vultr 面向开发者推出了全新的限时算力激励方案。新注册用户通过专属通道完成开通与验证,即可直接获赠高达 $300 的免费试用额度,有效期长达 30 天。
更关键的是,这笔额度不仅能用于创建常规的云服务器,更可全额直接抵扣 Vultr 官方推出的 Serverless Inference(无服务器推理平台)。在平台最新支持的模型列表中,包含 DeepSeek V4.1 Flash,GLM-5.3-Flash,Qwen 3.8 Flash 等最新强力编程模型,更包含生图模型 Z-image Turbo。定价参考各家官网,非常给力。配合原生兼容 OpenAI 的标准接口协议,全栈开发者完全可以在零自费的前提下,为本地的 Cursor、Claude Code 或 Codex 注入整整一个月的顶级开源算力。
💡 核心速览
- 💰 $300 真实试用算力:新用户通过专属推荐通道注册并完成验证,立享 $300 免费额度,有效期 30 天。
- 🚀 首批支持最新 DeepSeek V4.1 Flash:直接提供深度求索最新迭代的 V4.1 Flash 旗舰 MoE 模型,具备亚秒级首字延迟与深度代码推理规划能力。
- 🌐 原生兼容 OpenAI API 标准:Base URL 统一为
https://api.vultrinference.com/v1,无需额外搭建中转网关,直接即插即用。 - 🛠️ 主流 Coding Agent 几分钟完成接入:全面兼容 Cursor、Claude Code、Codex、Pi 与 ZCode 等前沿编程环境,轻松搭建全自动重构与测试工作流。
- 🛡️ 贴心防反向扣款策略:附赠实用的 30 天防反扣费设置、日历提醒与控制台消费阈值告警指南,确保真正做到无忧免费试用。
🔥 一、活动详情与算力价值:$300 到底有多耐用?
对于日常高频使用 AI 辅助编程的开发者而言,商业闭源模型每月几十美元的账单往往是一笔不小的开销。而自己租用 GPU 算力服务器部署开源大模型,不仅需要繁琐的环境配置,单个 GPU 实例每小时的闲置成本也令人心疼。
Vultr 推出的 Serverless Inference 恰好击中了这个痛点:采用纯按量(Per-Token)计费模式,不发请求就不产生任何费用,而新用户赠送的 $300 体验金正是天然的“算力粮仓”。
1. 极限算力折算:上亿 Tokens 免费畅用
以平台主推的最新旗舰 DeepSeek V4.1 Flash 官方费率为例:
- 输入价格:$0.15 / 100万 Tokens
- 输出价格:$0.60 / 100万 Tokens
将 $300 额度折算为代码开发场景中的真实吞吐:
- 单纯用于输入长上下文,可吞吐超过 20 亿 Tokens 的技术文档与代码仓库;
- 按照典型的代码生成与推理比例(1:1 或 1:2),综合可获得超过 3 亿至 5 亿混合 Tokens 的庞大处理量;
- 相当于支持自动补全与重构数万个中大型模块、执行上万次自动化单元测试审查。
即便对于每天深度使用 AI 编程 8 小时以上的全栈工程师,一个人在 30 天内也很难将这 $300 额度完全耗尽。
2. 丰富的开源大模型生态矩阵
除了最新一代 DeepSeek V4.1 Flash 等编程模型,Vultr Serverless Inference 还收录了一整套涵盖图像生成、向量检索与安全风控的多元模型生态,支持在控制台使用同一个 API Key 随时横向调度:
- GLM 5.3:智谱 AI 目前的旗舰大模型,如果写复杂业务代码卡壳或需要深度中文逻辑推演,可以随时向它求助;
- Z-Image Turbo:极速 AI 图像生成模型,支持通过 Prompt 快速生成高质量配图与视觉素材,且无需额外输出 Token 计费;
- BGE M3:智源研究院著名的多语言全功能向量 Embedding 模型,专用于项目知识库切片向量化与 RAG 语义检索;
- Vultron Retriever Core 4.5B / Flash 0.8B:Vultr 自研的 RAG 语义稠密检索矩阵,适合构建高召回率的本地代码与文档搜索链路;
- Nemotron 3.5 Content Safety:NVIDIA 官方出品的内容安全审核模型,专门用于拦截越狱 Prompt、敏感输入过滤与 API 安全网关加固;
- Muse Glimmer 30B:专为文学创意写作与沉浸式角色扮演深度调优的垂直大模型,适合剧情推演与拟人交互场景。
🛠️ 二、极速领取与 API 开通流程
第一步:通过专属通道注册账号
打开浏览器,访问官方专属算力活动链接: 👉 https://www.vultr.com/?ref=9923295-9J
输入常用的电子邮箱并设置高强度密码完成注册,随后前往注册邮箱查收确认邮件完成激活。
第二步:绑定支付方式完成身份过验
登录控制台后,系统会引导进入 Billing(账单)页面进行身份真实性核验。
在此需要绑定一张 Visa、MasterCard 或运通等外币信用卡,或者通过 PayPal 完成一笔首充验证款。Vultr 作为全球老牌纳斯达克背景的合规云厂商,此步骤主要用于杜绝批量注册与自动化羊毛刷子。绑定成功后,赠送的 $300 体验金额度将立即显示在账户余额中。
第三步:开通 Serverless Inference 并获取 API Key
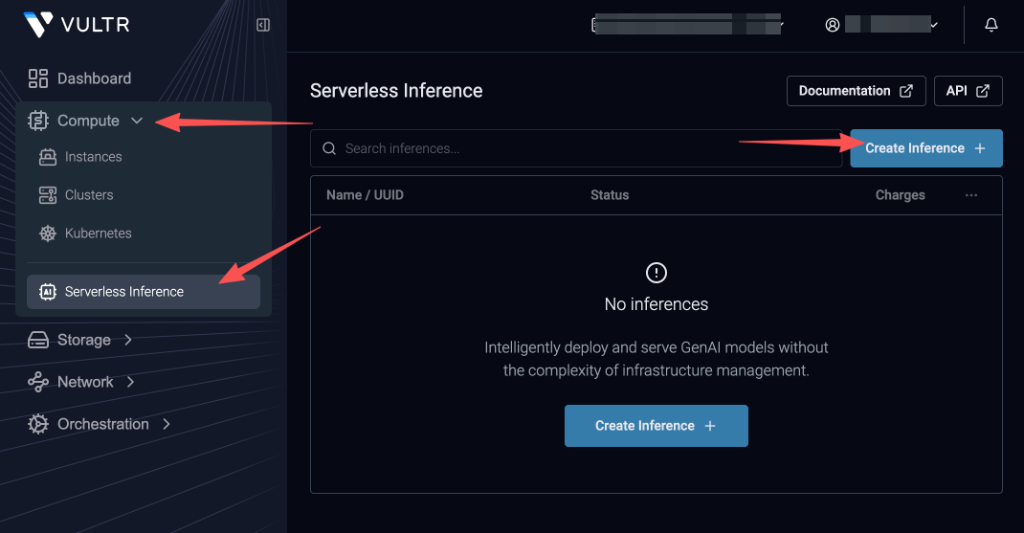
- 在 Vultr 控制台左侧导航栏中,展开 Compute 并点击进入 Serverless Inference 板块;
- 首次进入时点击右上角或中央的 Create Inference + 按钮开启推理服务;
- 创建 Inference 成功之后,点击刚创建的 Inference,找到 API key 并复制保存下来
- 官方标准 API Base URL 为:
https://api.vultrinference.com/v1。
💻 三、主流开发工具与 Coding Agent 极速接入
由于 Vultr Serverless Inference 原生完全兼容 OpenAI API 规范,主流编程辅助工具均可在数分钟内无缝直连。
1. Cursor 配置
在 Cursor 中直接使用 Vultr 托管的 DeepSeek V4.1 Flash 非常简单:
- 打开 Cursor,按下快捷键
Cmd + ,或点击右上角齿轮图标进入 Settings; - 在左侧菜单中切换至 Models 标签页;
- 展开 OpenAI API Key 选项,填入从 Vultr 复制的 API Key;
- 开启 Override OpenAI Base URL 开关,将地址修改为:
https://api.vultrinference.com/v1; - 在模型列表中点击 Add Model,新增模型标识:
DeepSeek-V4.1-Flash,保存即可生效。
2. Claude Code 接入
在终端环境中,只需将官方环境变量重定向至 Vultr 的兼容网关:
export OPENAI_BASE_URL="https://api.vultrinference.com/v1"
export OPENAI_API_KEY="your_vultr_api_key_here"
如果使用兼容 OpenAI 格式的客户端启动脚本,将模型参数指定为 DeepSeek-V4.1-Flash 即可顺畅运行。
3. Codex、Pi 与 ZCode 适配
在 Codex、Pi 或 ZCode 的 Provider 设置选项中,选择自定义 OpenAI 兼容服务商(Custom OpenAI Provider):
- API Base URL:
https://api.vultrinference.com/v1 - API Key:你的 Vultr API Key
- Model Name:
DeepSeek-V4.1-Flash(极速代码与推理)、Qwen-3.8-Flash-Next(轻量流式补全)
4. 代码直接调用示例
如果你希望在自建应用、自动化脚本或后端服务中直接调用,以下是开箱即用的代码示例:
cURL 终端调用
curl https://api.vultrinference.com/v1/chat/completions \
  -H "Authorization: Bearer $VULTR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "DeepSeek-V4.1-Flash",
    "messages": [
      {"role": "system", "content": "You are a professional full-stack engineer."},
      {"role": "user", "content": "Write a clean TypeScript helper function to debounce asynchronous promises with immediate execution."}
    ],
    "temperature": 0.2
  }'
Python 官方 SDK 调用
from openai import OpenAI

client = OpenAI(
    base_url="https://api.vultrinference.com/v1",
    api_key="YOUR_VULTR_API_KEY",
)

response = client.chat.completions.create(
    model="DeepSeek-V4.1-Flash",
    messages=[
        {"role": "system", "content": "You are a professional full-stack engineer."},
        {"role": "user", "content": "Write a clean TypeScript helper function to debounce asynchronous promises with immediate execution."}
    ],
    temperature=0.2,
)

print(response.choices[0].message.content)
⚠️ 四、核心避坑与安全防扣费指南
要想把这次的福利薅得舒心又踏实,以下几点至关重要,建议在领到额度后立即顺手做好配置:
1. 谨记 30 天有效期与日历提醒
赠送的 $300 体验金拥有严格的 30 天有效期,到期后未消耗完毕的赠金额度将由系统自动清零收回。
强烈建议:激活成功之后立刻开始使用,不要浪费。如果你要把它嵌入你的应用,可在手机日历中设置一个到期提醒,到时候选择继续使用或者切到其它服务商。
2. 控制台设置消费告警防扣款
为了防止 30 天赠金到期后超额消费被系统自动扣款,可以在 Vultr 控制台做好两道防线:
- 开启账单告警(Billing Alerts):在 Billing 设置中开启超额邮件预警,当账户发生真实自费扣款前第一时间接收通知;
- 到期及时解绑或禁用 Key:如果在 30 天试用期结束前不想转为自费客户,只需在 Serverless Inference 中将创建的 API Key 删除或停用,即可彻底切断调用产生费用的通道。
3. 提高绑卡与风控过验成功率
部分国内开发者在绑卡时可能会遇到风控拦截,这里有几个实用建议:
- 注册和绑卡时,尽量保持干净稳定的网络 IP,避免使用万人共用的廉价代理节点;
- 填写的账单地址尽量与信用卡发卡行预留的真实拼音或英文账单地址保持一致;
- 若实体信用卡多次提示错误,可以尝试使用国际版 PayPal 账户进行小额预存过验。
💡 五、长期主力口粮与方案对比
$300 体验金非常适合作为为期一个月的“算力突击营”,尤其适合正在进行密集项目重构、毕业设计冲刺或新产品 MVP 原型研发的开发者。但在体验期结束后,全栈工程师仍需考虑长期的生产力口粮方案:
- OpenCode Go:首月仅需 $10 即可获得 $15-$60 算力(续费 $10/月),全量覆盖主流开源与闭源商业模型,且对中国大陆开发者支付与网络环境极其友好,是日常最稳健的主力首选; 👉 OpenCode Go 专属特惠入口:https://opencode.ai/go?ref=SVE58K5K80
- Command Code GOAT 计划:主打 $10 换 $70 算力(7倍杠杆),内置针对开源模型的 Tool-call 自动纠错与神经符号偏好记忆,是专注于终端 Coding Agent 的优质备选;
建议采取“长短结合”的策略:利用 Vultr 赠送的 $300 免费算力重度畅享最新的 DeepSeek V4.1 Flash,同时保留一份 OpenCode Go 等低成本长期订阅,打造进退自如的混合算力底座。
📬 订阅 Free AI API 获取前沿情报
大模型降价、限时算力羊毛与 0 元 API 的窗口期瞬息万变。
欢迎持续关注我们的站点并订阅 Newsletter,第一时间获取国内外最新 API 动态、真实深度测评与最划算的开发者福利指南!
社区反馈
评论与你的 GitHub 账号绑定,登录后即可参与讨论。