
¡Consigue $300 de Cómputo Gratis! Guía de 30 Días de Vultr Serverless Inference para DeepSeek V4.1 Flash y GLM-5.3-Flash
En septiembre de 2026, el proveedor global de infraestructura en la nube Vultr lanzó una atractiva iniciativa promocional de cómputo para desarrolladores. Los nuevos usuarios que se registran a través del canal de recomendación dedicado y completan la verificación básica de cuenta reciben $300 en créditos de prueba gratuitos, válidos durante 30 días completos.
Crucialmente, este saldo no se limita a servidores VPS tradicionales: cubre en su totalidad la plataforma oficial Serverless Inference de Vultr. El catálogo de modelos incluye el modelo insignia de código y razonamiento DeepSeek V4.1 Flash, junto con GLM-5.3-Flash, Qwen 3.8 Flash Next y el modelo de generación de imágenes Z-Image Turbo. Gracias a la compatibilidad nativa con la API de OpenAI, los desarrolladores full-stack pueden conectar este flujo de cómputo a Cursor, Claude Code, Codex, Pi o ZCode sin coste alguno durante un mes entero.
💡 Aspectos Destacados
- 💰 $300 en Saldo Real de Prueba: Nuevos usuarios registrados mediante el enlace exclusivo reciben $300 de crédito promocional con 30 días de vigencia.
- 🚀 Acceso Inmediato a DeepSeek V4.1 Flash: Disponibilidad directa de la última arquitectura MoE de DeepSeek con latencia subsegundo de primer token y planificación avanzada.
- 🌐 Compatibilidad Nativa con OpenAI API: Base URL unificada en
https://api.vultrinference.com/v1, sin necesidad de proxies inversos ni pasarelas intermedias. - 🛠️ Integración Rápida con Coding Agents: Conexión lista en menos de tres minutos con Cursor, Claude Code, Codex, Pi y ZCode.
- 🛡️ Protección Contra Cargos Inesperados: Consejos prácticos sobre alertas de facturación, recordatorios en calendario y gestión del fin de prueba para evitar sorpresas en la tarjeta.
🔥 1. Detalles de la Promoción y Economía de Tokens: ¿Cuánto Rinden $300?
Para los ingenieros que utilizan asistentes de programación con IA a diario, los costes de modelos comerciales cerrados pueden dispararse rápidamente. Al mismo tiempo, desplegar modelos abiertos en instancias GPU dedicadas acarrea elevados costes fijos por horas de inactividad.
Vultr Serverless Inference resuelve esto mediante un esquema de cobro estrictamente por uso (por token): solo pagas cuando envías una petición, y el bono de $300 actúa como una reserva masiva de cómputo gratuito.
1. Desglose del Valor de Tokens: Cientos de Millones Gratis
Tomando como referencia los precios oficiales de DeepSeek V4.1 Flash:
- Entrada: $0.15 por millón de Tokens
- Salida: $0.60 por millón de Tokens
Al traducir $300 en capacidad de ingeniería de software:
- Permite procesar más de 2.000 millones de tokens de documentación y código fuente en contexto de entrada;
- Con ratios típicos de generación de código (1:1 o 1:2), rinde entre 300 y 500 millones de tokens combinados;
- Equivale a refactorizar decenas de miles de módulos medianos y grandes o ejecutar suites completas de pruebas automatizadas.
Incluso para desarrolladores full-stack que programan intensivamente con IA durante más de 8 horas al día, consumir $300 en 30 días es prácticamente inalcanzable.
2. Ecosistema Diverso de Modelos de Código Abierto
Además de DeepSeek V4.1 Flash, Vultr Serverless Inference reúne un ecosistema multidisciplinar disponible bajo la misma API Key:
- GLM 5.3: El modelo insignia actual de Zhipu AI, ideal para análisis arquitectónico profundo y resolución de bloqueos lógicos complejos;
- Z-Image Turbo: Modelo de generación de imágenes de alta velocidad a partir de texto, sin coste de tokens de salida;
- BGE M3: Destacado modelo de embeddings multilingüe de BAAI, esencial para fragmentación documental y recuperación semántica RAG;
- Vultron Retriever Core 4.5B / Flash 0.8B: La pila de recuperación densa de Vultr para crear motores de búsqueda de baja latencia sobre bases de conocimiento;
- Nemotron 3.5 Content Safety: Modelo de clasificación de seguridad de NVIDIA para interceptar inyecciones y blindar pasarelas de API públicas;
- Muse Glimmer 30B: Optimizado para escritura creativa, narrativa y diálogos conversacionales.
🛠️ 2. Guía Paso a Paso para Obtener tu API Key
Paso 1: Regístrate Mediante el Enlace de Recomendación
Abre el navegador y accede al portal promocional oficial: 👉 https://www.vultr.com/?ref=9923295-9J
Introduce tu correo y una contraseña segura, y confirma la cuenta mediante el enlace de verificación recibido por email.
Paso 2: Valida tu Identidad con un Método de Pago
Accede a la consola de Vultr y dirígete al apartado Billing para verificar la autenticidad de tu cuenta.
Vincula una tarjeta de crédito internacional (Visa, MasterCard o American Express) o efectúa un depósito de validación con PayPal. Como proveedor regulado en bolsa, Vultr utiliza este control para evitar granjas de bots. Tras validar, el saldo de $300 se acreditará inmediatamente.
Paso 3: Activa Serverless Inference y Copia tu Clave
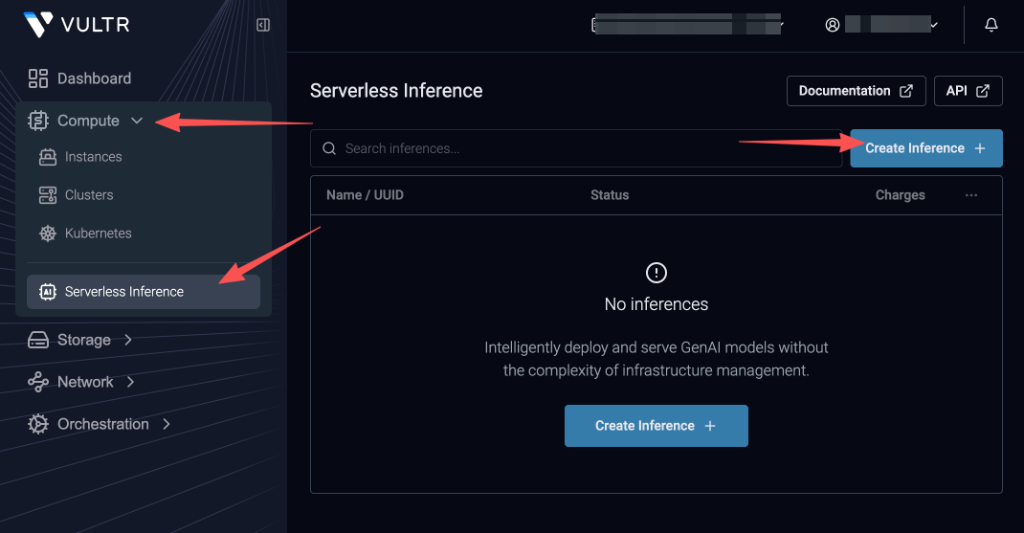
- En el menú de navegación lateral, despliega Compute y haz clic en Serverless Inference;
- En tu primer acceso, haz clic en el botón Create Inference + situado en el centro o arriba a la derecha;
- Una vez creada la inferencia, haz clic en ella, localiza tu API Key y cópiala en tu gestor de contraseñas o variables de entorno;
- La dirección Base URL oficial compatible con OpenAI es:
https://api.vultrinference.com/v1.
💻 3. Configuración en Entornos de Desarrollo y Coding Agents
Dado que Vultr Serverless Inference cumple rigurosamente con la especificación de OpenAI, la integración en tus herramientas habituales toma solo un par de minutos.
1. Configuración en Cursor
- Abre Cursor y pulsa
Cmd + ,o haz clic en el engranaje para abrir Settings; - Ve a la pestaña Models en el menú izquierdo;
- Despliega OpenAI API Key y pega la clave generada en Vultr;
- Activa Override OpenAI Base URL e introduce:
https://api.vultrinference.com/v1; - En la lista de modelos, pulsa Add Model y añade:
DeepSeek-V4.1-Flash. Guarda los cambios.
2. Conexión con Claude Code
En entornos de terminal, redirige las variables compatibles con OpenAI antes de ejecutar tu agente:
export OPENAI_BASE_URL="https://api.vultrinference.com/v1"
export OPENAI_API_KEY="tu_clave_de_vultr_aqui"
Configura el cliente para apuntar a DeepSeek-V4.1-Flash como modelo predeterminado.
3. Integración en Codex, Pi y ZCode
En el panel de configuración de proveedor de Codex, Pi o ZCode, selecciona la opción Custom OpenAI Provider:
- API Base URL:
https://api.vultrinference.com/v1 - API Key: Tu clave de Vultr
- Model Name:
DeepSeek-V4.1-Flash(para razonamiento y codificación compleja) oQwen-3.8-Flash-Next(para autocompletado ultrarrápido)
4. Ejemplos de Llamada Directa a la API
Solicitud con cURL en Terminal
curl https://api.vultrinference.com/v1/chat/completions \
  -H "Authorization: Bearer $VULTR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "DeepSeek-V4.1-Flash",
    "messages": [
      {"role": "system", "content": "You are a professional full-stack engineer."},
      {"role": "user", "content": "Write a clean TypeScript helper function to debounce asynchronous promises with immediate execution."}
    ],
    "temperature": 0.2
  }'
Código Python con el SDK Oficial
from openai import OpenAI

client = OpenAI(
    base_url="https://api.vultrinference.com/v1",
    api_key="TU_VULTR_API_KEY",
)

response = client.chat.completions.create(
    model="DeepSeek-V4.1-Flash",
    messages=[
        {"role": "system", "content": "You are a professional full-stack engineer."},
        {"role": "user", "content": "Write a clean TypeScript helper function to debounce asynchronous promises with immediate execution."}
    ],
    temperature=0.2,
)

print(response.choices[0].message.content)
⚠️ 4. Recomendaciones Cruciales de Seguridad y Control de Facturación
Para disfrutar al máximo de la prueba sin sorpresas, aplica estas buenas prácticas tras dar de alta la cuenta:
1. Empieza de Inmediato y Programa un Recordatorio
El saldo promocional de $300 caduca a los 30 días naturales; cualquier remanente no consumido se anulará automáticamente.
Recomendación: Empieza a utilizar los créditos inmediatamente tras la activación. Si vas a integrar la API en servicios continuos, configura una alarma en el calendario en torno al día 28 para evaluar si continuar en Vultr o migrar hacia otra alternativa.
2. Configura Alertas de Consumo en la Consola
Para evitar que el tráfico posterior a la prueba genere cargos automáticos en tu tarjeta:
- Activa Alertas de Facturación: En la configuración de Billing, habilita notificaciones por correo electrónico ante umbrales de gasto;
- Elimina o Inhabilita la Clave: Si al finalizar el periodo de prueba no deseas continuar como usuario de pago, borra o desactiva la API Key en Serverless Inference para detener el tráfico.
3. Consejos para Superar la Verificación Antifraude
Para evitar bloqueos automáticos en el proceso de registro:
- Emplea conexiones residenciales o empresariales limpias, evitando nodos proxy compartidos masivamente;
- Asegúrate de que la dirección de facturación coincida con los datos registrados en tu tarjeta;
- Si la tarjeta bancaria presenta rechazos reiterados, opta por la verificación mediante una cuenta internacional de PayPal.
💡 5. Comparativa de Alternativas de Cómputo a Largo Plazo
Un saldo de $300 representa una oportunidad perfecta para abordar refactorizaciones complejas o lanzar prototipos MVP. Una vez concluida la prueba, considera estas opciones sostenibles a largo plazo:
- OpenCode Go: Ofrece de $15 a $60 en créditos de cómputo por $10/mes, amplia variedad de modelos y pagos sin fricción internacional; 👉 Entrada exclusiva a OpenCode Go: https://opencode.ai/go?ref=SVE58K5K80
- Plan Command Code GOAT: Entrega $70 de saldo por $10/mes (apalancamiento 7x), con memoria neurosimbólica de estilo y corrección automática de llamadas a herramientas.
Una estrategia equilibrada aprovecha los $300 gratuitos de Vultr para llamadas masivas a DeepSeek V4.1 Flash, manteniendo una suscripción económica como OpenCode Go como base de trabajo diaria.
📬 Suscríbete a Free AI API para Novedades Verificadas
Las tarifas de modelos de IA, promociones sin coste y concesiones de cómputo cambian velozmente.
Sigue Free AI API y únete a nuestra newsletter para recibir comparativas técnicas independientes, alertas de descuentos reales y guías de APIs gratuitas directamente en tu bandeja de entrada.
Comentarios de la comunidad
Los comentarios están vinculados a tu cuenta de GitHub; inicia sesión para participar en la discusión.